deciax:用 JAX 和 Pallas 在 TPU 上运行 Decision Model
- EN
- ZH-CN
Table of Contents
给一条工单选部门、判断是否需要退款、给紧急程度打分,这些任务需要的是几个结构化判断。模型可以直接输出选项和概率,不必逐 token 生成一段回答。
Laya 就是这样一个 Decision Model:用一次前向计算处理选择、评分和是非问题。我把它的推理路径移植到了 JAX,做成了 deciax,让这类模型可以在 TPU 上运行,再用 Pallas 优化其中的计算。
这次测试里1,单芯片 TPU v6e 的英文模型单问题调用 p50 是 2.18 ms,多语言模型是 1.55 ms。作为对比,A100 SXM4、H100 PCIe、H200 NVL 的最快实测结果分别是 6.4 / 4.0 ms、4.8 / 3.2 ms、5.8 / 4.1 ms(英文 / 多语言)。
每次 50 个问题时,v6e Pallas 的 p50 是 33.69 / 17.83 ms,相较普通 JAX 实现提速约 2.3 倍;A100、H100、H200 的最快实测结果分别是 68.8 / 36.2 ms、44.0 / 23.2 ms、39.8 / 21.2 ms。
#
一条输入,几个判断
deciax 接收输入和一组问题,返回结构化结果。以一条重复扣款的工单为例:
import deciax

decider = deciax.load("laya")
result = decider.decide(
    {"user": "I was charged twice this month. Please refund the duplicate."},
    {
        "department": {
            "type": "choice",
            "instructions": "Which department should handle this?",
            "criteria": {
                "billing": "payments, invoices, refunds",
                "technical": "bugs, outages, system errors",
                "other": "everything else",
            },
        },
        "urgency": {
            "type": "score",
            "instructions": "How urgent is this?",
            "criteria": ["not urgent", "soon", "blocking"],
        },
        "refund_requested": {
            "type": "noul",
            "instructions": "Does the user ask for a refund?",
        },
    },
)
print(result)
#
把推理路径移到 JAX
deciax 保留了 Laya 的输入构造、ModernBERT encoder 和决策 head,把推理计算换成 JAX。运行时不需要安装 PyTorch、Transformers 或 Laya;checkpoint 和 tokenizer 仍沿用原项目的模型。项目也提供 /v1/systemone HTTP 接口。项目说明列出了当前支持范围。
#
先看未优化基线:PyTorch eager 与 JAX
测试在 Oct 12, 2026 进行,覆盖 RTX 3090、A100 SXM4、RTX A6000、H100 PCIe 和 H200 NVL,以及各用一颗芯片的 TPU v5e、v6e。
延迟图展示进程内调用的稳态 p502,包含输入编码、推理和结果处理。实心柱是 p50,虚线标记 p95。
先只看 GPU 的 PyTorch eager 和 TPU 的普通 JAX 实现:
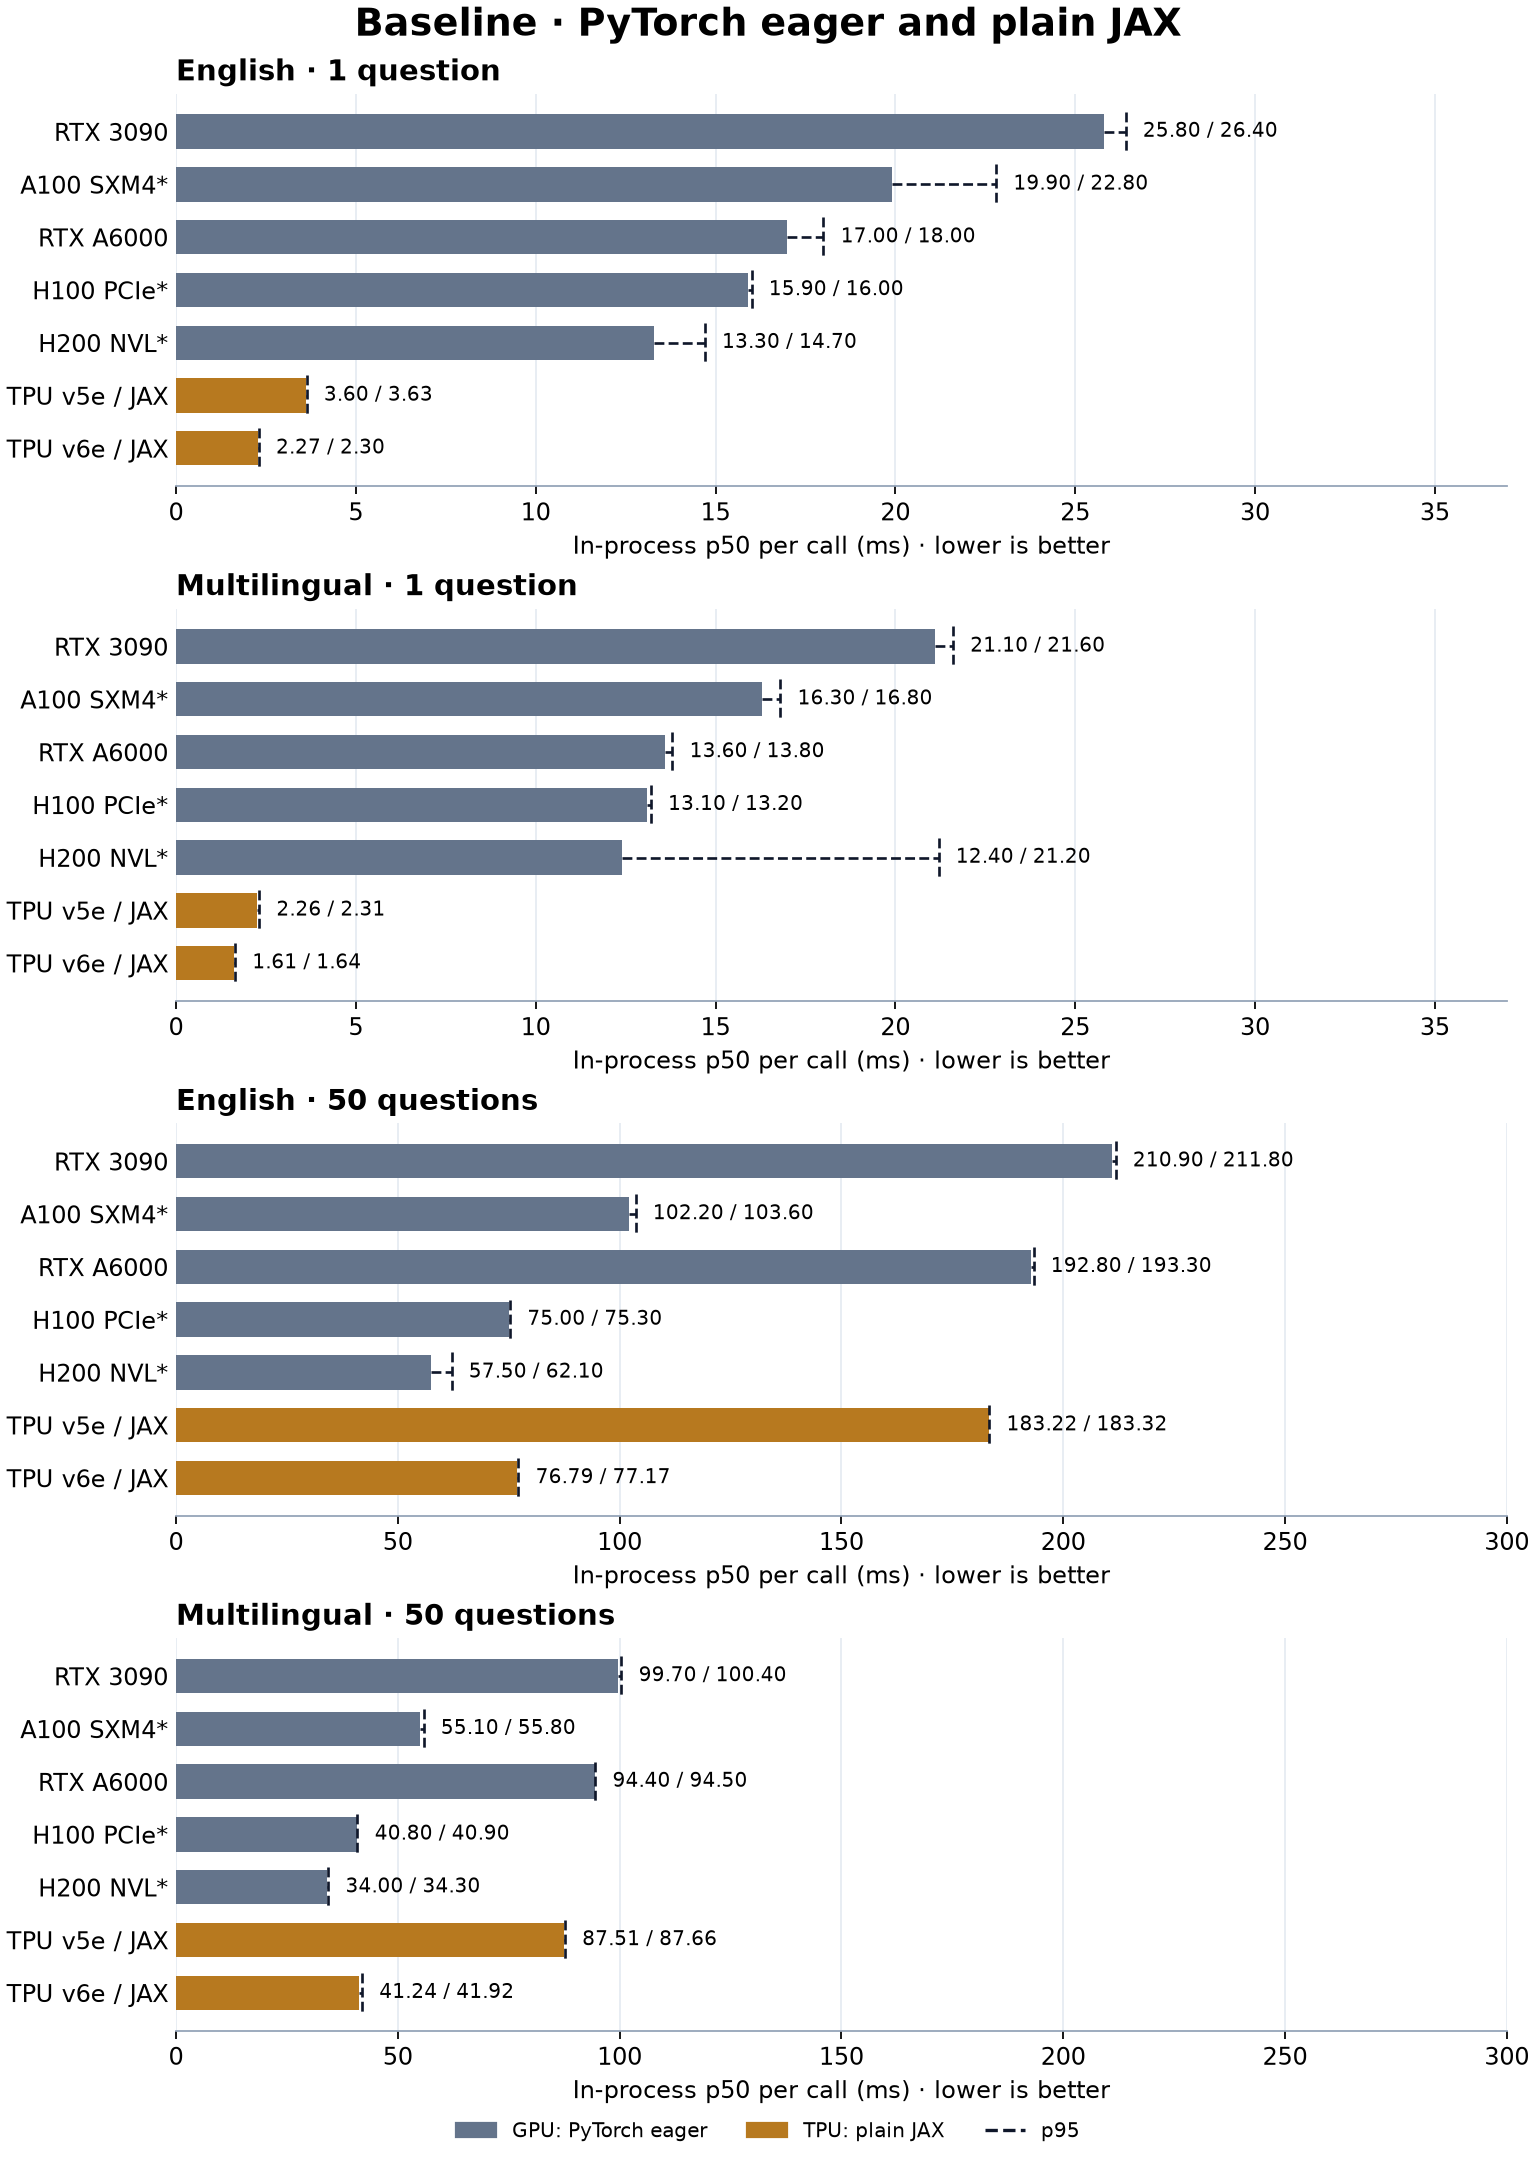
英文模型单问题调用,GPU eager 的 p50 是 13.3–25.8 ms,v6e JAX 是 2.27 ms。但每次 50 个问题时,v6e JAX 需要 76.79 ms,GPU eager 的最低值是 H200 NVL 的 57.5 ms。多语言模型也有类似变化:v6e JAX 从单问题的 1.61 ms 增长到 50 问题的 41.24 ms,H200 eager 的 50 问题结果是 34.0 ms。
#
观察耗时:调度开销和模型计算
接着拆开基线调用的耗时,以英文模型为例3:
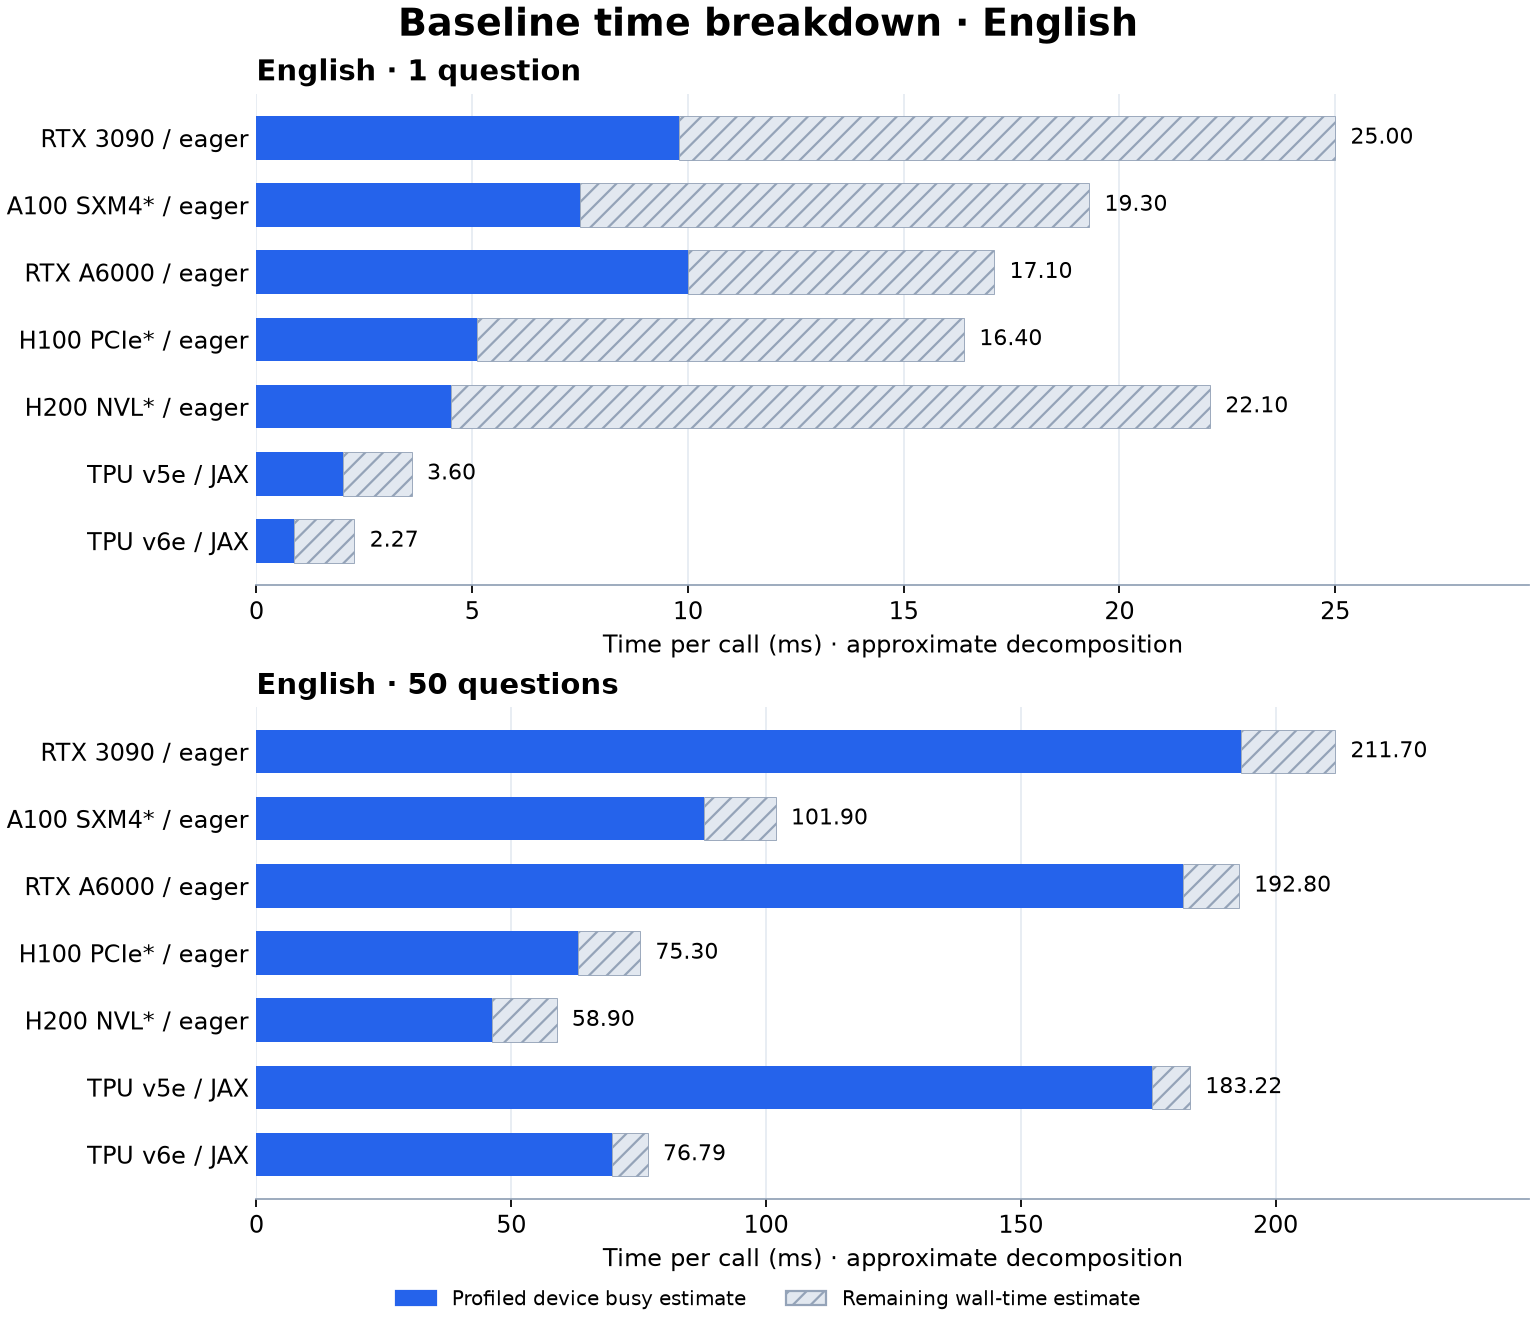
单问题的 GPU eager 调用包含大量小 kernel:英文模型一次调用就有 1090–1213 次 cudaLaunchKernel。设备执行之外的余量很大,优化需要同时考虑 kernel 融合和调用开销。
每次 50 个问题时,计算本身开始占主要时间。v6e JAX 的英文模型总延迟为 76.79 ms,其中单独测量的 forward-only 是 71.27 ms,输入编码约 3 ms。XProf 中,dot_general 和 sub 分别占这组设备时间的约 38% 和 21%,提示我们关注矩阵计算和逐元素操作的数据搬运。
移植以后,以 JAX 算子作为基线,看 TPU 上的计算如何融合。在本次测试形状下,Pallas 把每层的多项计算融合到同一个 kernel 中4。
#
优化后:对比各平台最快的实现
GPU 侧测试覆盖 TileLang、CUDA Graph 和 torch.compile,选取每台主机、每个模型与问题数下实测最快的实现,以尽可能保证公平。TPU 侧使用 v6e Pallas。
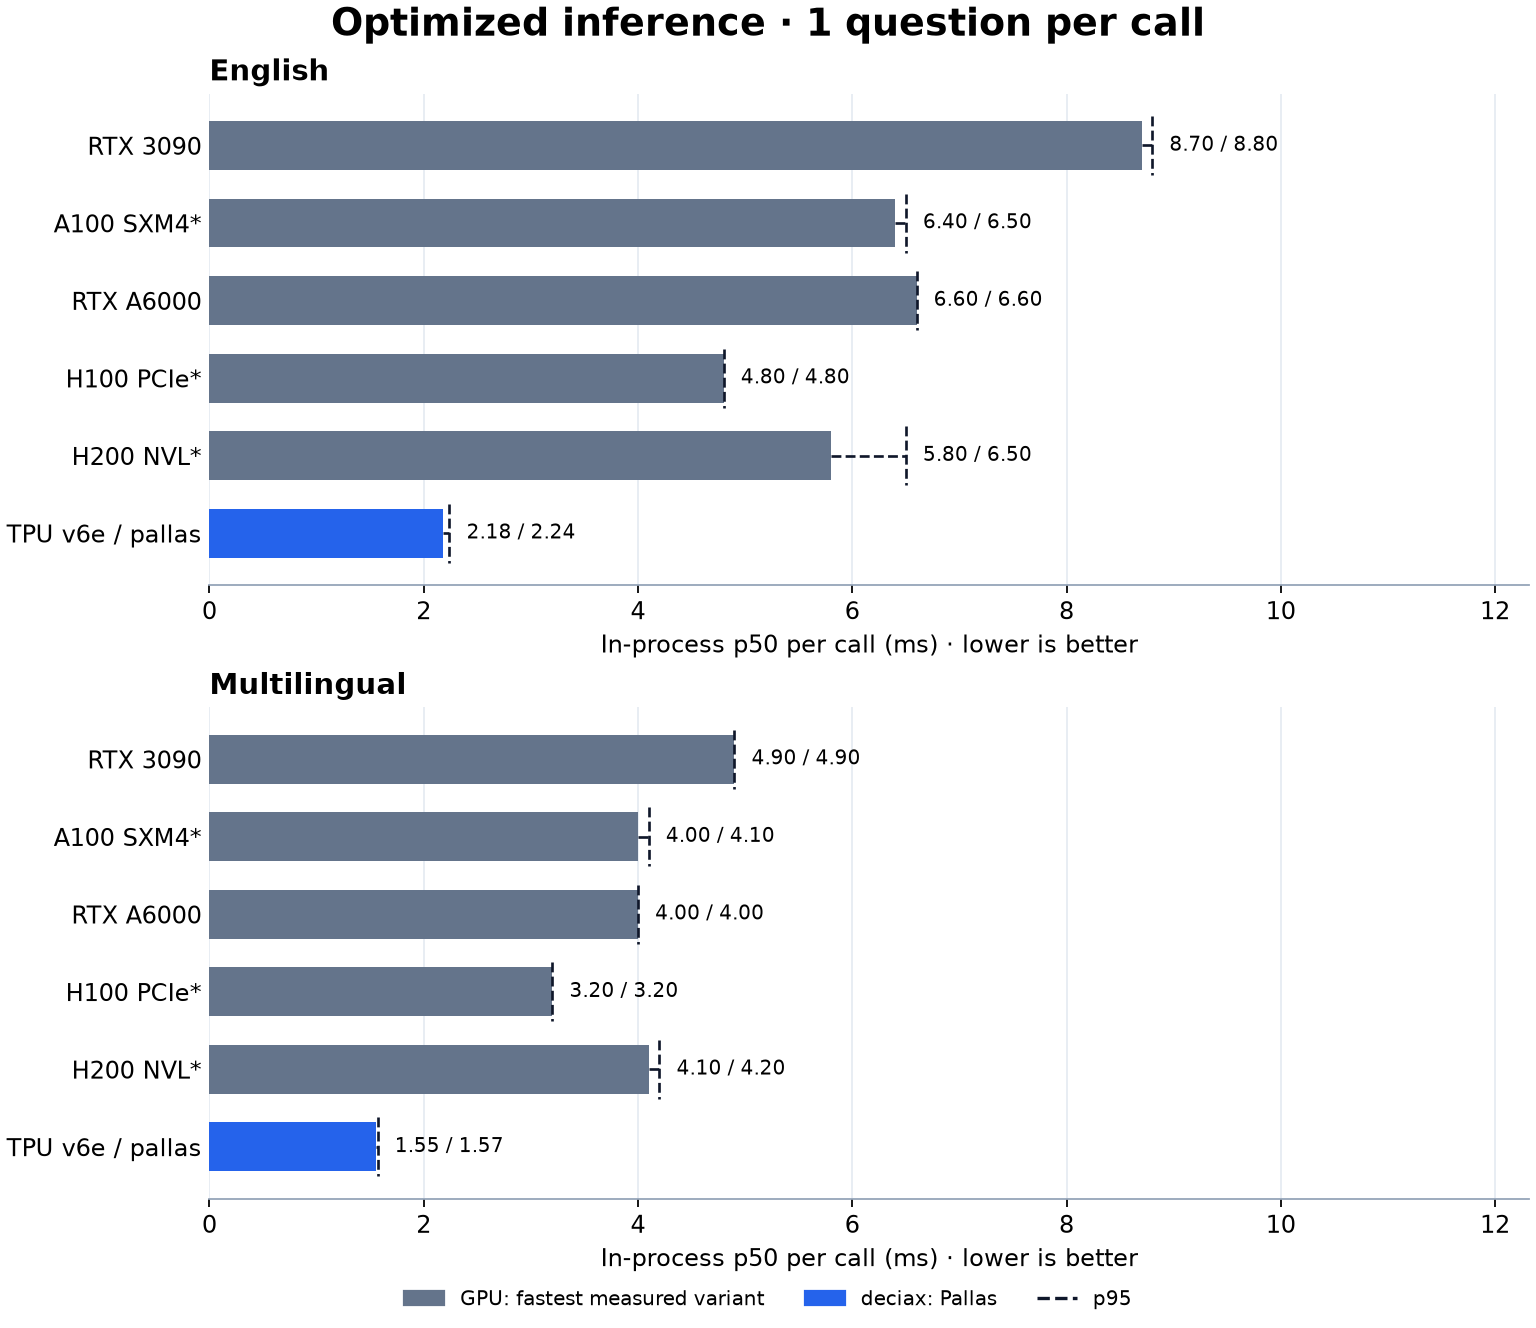
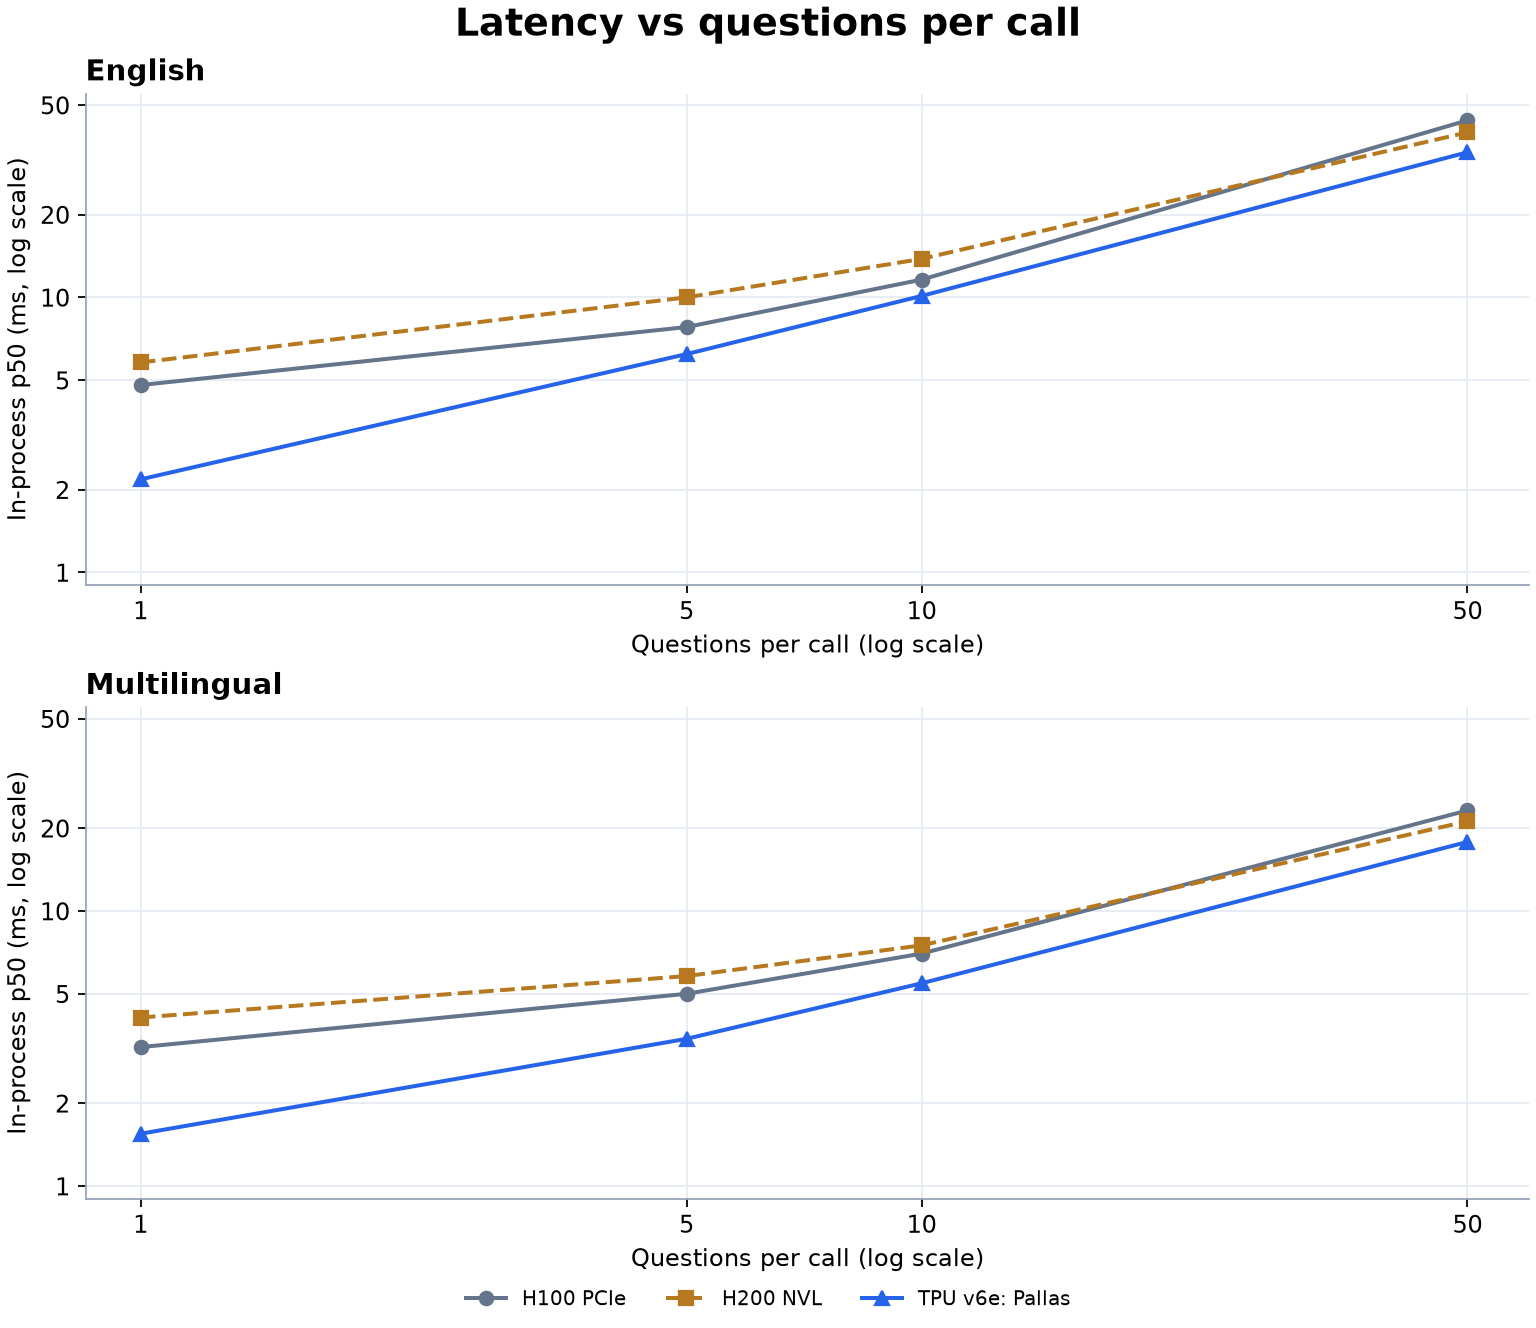
单问题调用,v6e Pallas 的英文模型 p50 是 2.18 ms,多语言模型是 1.55 ms。GPU 的英文模型最低值是 H100 PCIe 上 torch.compile with cudagraph 的 4.8 ms,多语言模型最低值是 3.2 ms。这个形状下,Pallas 相比普通 JAX 的改善很小。
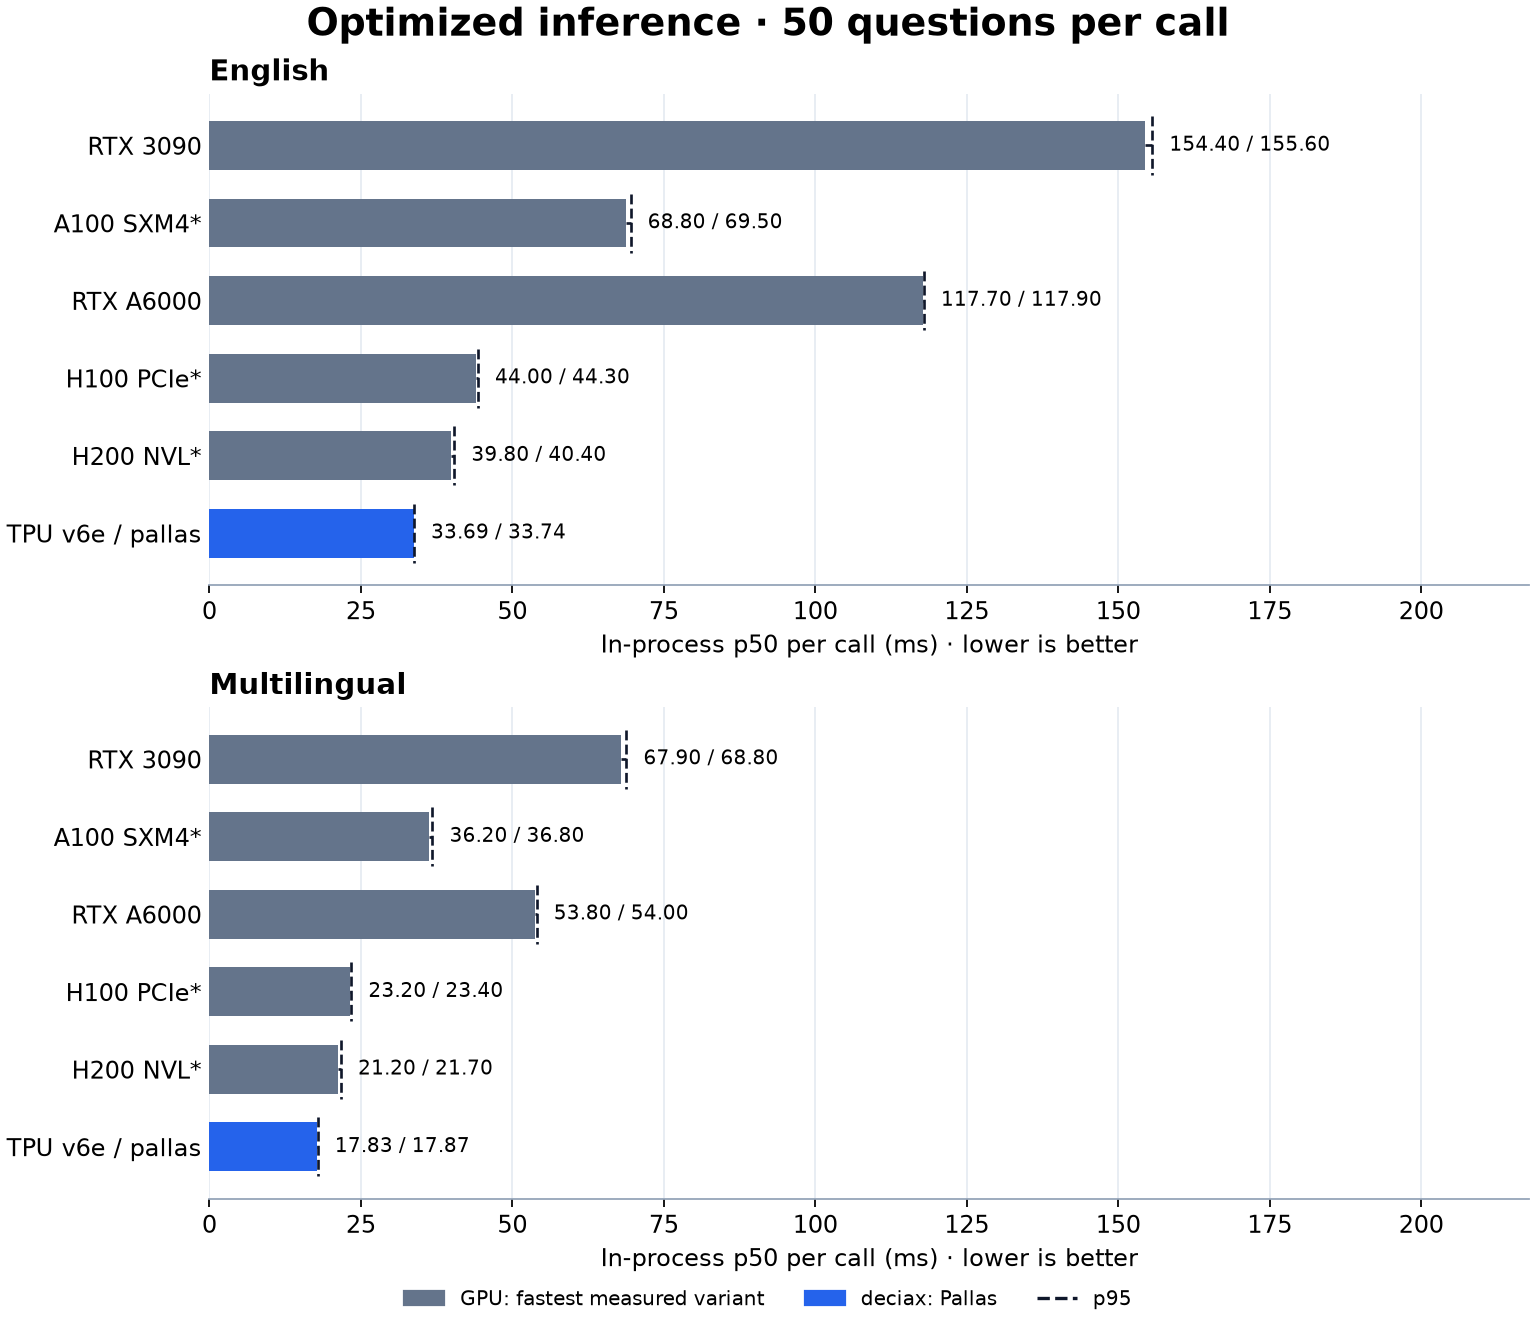
每次 50 个问题,v6e 的英文模型从 JAX 的 76.79 ms 降到 Pallas 的 33.69 ms,多语言模型从 41.24 ms 降到 17.83 ms,分别提速 2.28 倍、2.31 倍。英文模型的 forward-only 从 71.27 ms 降到 28.25 ms,多语言模型从 36.54 ms 降到 13.36 ms。
#
延迟如何随问题数变化
把每次 1、5、10、50 个问题连起来,对比 H100、H200 与 v6e Pallas 的延迟变化:
#
HTTP 服务与安装
我们也测了 deciax.serve。单问题、loopback、keep-alive 条件下,v6e Pallas 的 HTTP p50 是英文 3.0 ms、多语言 2.4 ms。这包含本机 HTTP 往返,但没有外部网络延迟,也没有并发负载测试。
使用 Python 3.14 或更高版本。在 TPU 环境中安装:
python -m pip install "deciax[tpu]==0.1.1"
这个版本可以用于上面的 Python 接口示例。要检查本次 Pallas 实现,可以从项目仓库检出报告对应的代码:
git clone https://github.com/Junyi-99/deciax.git
cd deciax
git checkout 6f3a930
uv sync --extra tpu
#
Cost:Million model input tokens per US dollar
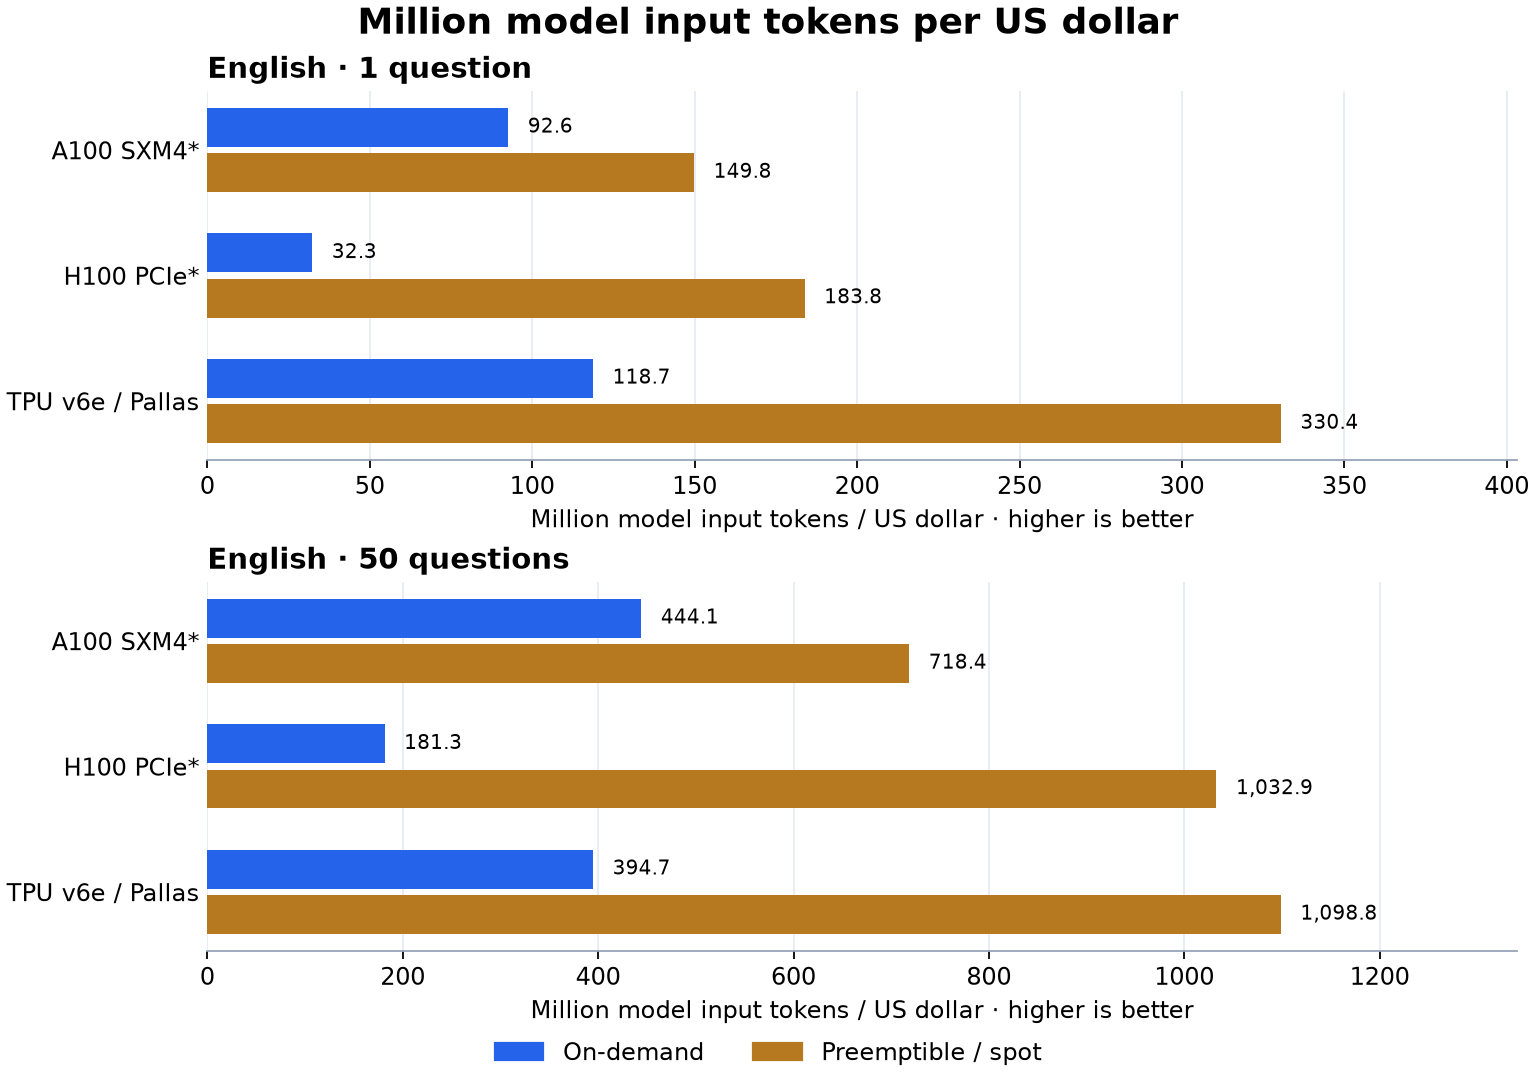
成本只比较 English model 的优化版本:GPU 取前面的实测最快实现,TPU 只放 v6e Pallas。分别按 on-demand 与 preemptible / spot 两种小时价格计算。
性能数据和价格数据采集于 Oct 12, 2026。
价格单位:USD / GPU-hour 或 TPU chip-hour。
| 硬件 | 供应商 | On-demand | Preemptible / Spot5 |
|---|---|---|---|
| A100 SXM4 80GB | Vast.ai | $1.176 | $0.727 |
| H100(SXM 报价) | Nebius | $4.500 | $0.790 |
| H200(SXM 报价) | Nebius | $5.400 | $0.790 |
| TPU v6e | Google Cloud | $2.700 | $0.970 |
计算公式是6:
Million model input tokens per US dollar
  = model input tokens per second × 3600 / hourly price / 1,000,000
这里的 model input tokens 包含各问题重复的工单文本。
#
总结
deciax 把 Laya 的结构化决策能力带到了 TPU 上。这次实验中,普通 JAX 已经能把单问题调用做到约 2 ms,Pallas 在这个形状下的额外收益很小;当每次调用增加到 50 个问题,融合后的 Pallas 路径相较普通 JAX 提速约 2.3 倍。问题数改变了主要开销,也改变了优化的收益。
在本文测试的输入、模型和实现范围内,v6e Pallas 的单问题和 50 问题延迟都低于参与对比的 GPU 实现。
如果你想试试 deciax,可以在 Colab 中体验,也可以到 GitHub 仓库查看代码。
输入采用上游的 Payout failing 工单,问题交替使用
noul和choice。每组先预热 20 次,再计时 20 次,并等待设备计算完成。 ↩︎耗时拆解图中的 GPU p50 来自 profiling 配套的独立计时,与前一张基线图的测试序列不同。 ↩︎
本次报告中的 Pallas 路径融合了 norm、QKV 投影、RoPE、attention、输出投影和 MLP。对于序列长度不超过 512 的路径,每层使用一次
pallas_call。 ↩︎Nebius Spot 使用起始价;TPU preemptible 使用报告快照。 ↩︎
English model 每次单问题调用有 194 个 model input tokens,每次 50 问题有 9975 个。吞吐采用报告记录的 input tokens/s,由输入 token 数除以原始 p50 延迟得到。 ↩︎