Agent Mesh:聊聊我对多 AI 协同工作流的一些想法
- EN
- ZH-CN
现在 AI 编程助手越来越多,从聊天框一路卷到了跑在命令行里的 Agent。用了一圈下来,我最大的感受是:没有哪个 Agent 能在所有方面都做到最好。
我日常主要在用 Claude Code、Google Gemini CLI 和 Moonshot Kimi Code。一开始也是把它们当独立工具用,后来发现这样太浪费了,因为它们各有各的长板,如果让它们根据各自的优势互相配合、互相委派任务,效果会好很多。我把这个思路叫做 Agent Mesh。
#
核心角色:我的观察和真实体验
##
Claude Code:规划与执行
我主要用 Claude Code 创建项目和重构代码。它能遍历文件、运行 bash、修复编译错误,接着执行下一步。我已经在所有服务器上安装了它。短板是幻觉,尤其是在生成大段文档、或者引用它没吃透的大型系统时,它会编东西出来。
##
Gemini CLI:大数据吞吐者与“幻觉检查员”
Gemini 最大的优势是那个 200 万 Token 的上下文窗口。实测下来,它真的能一口气吞掉整个仓库、很长很长的错误日志,我试过几百 K 的那种。正因为它能把整个宏观上下文都装进脑子里,它天然就是比较好的审计者。当 Claude Code 生成了一个出色但可能存在幻觉的代码方案时,可以调用 Gemini 进行大规模跨文件验证。
##
Kimi Code:深度推理者与数据挖掘者,待评估
Kimi Code 走的是一条完全不同的路。它底层是 K2.5 的"长思考"模型 k0,走显式思维链,路子类似 OpenAI o1,再加上"Agentic Swarm"的玩法,理论上可以拉起一堆子 Agent 去网上多跳检索文档,或者死磕那种深度嵌套的算法难题。不过我得打个问号:Claude 和 Gemini 我是每天在用的,它们的能力边界我心里有数,但 Kimi 在"数据挖掘"和"深度推理"上到底比其他两个强多少,说实话我目前主要是看它架构上的宣称,还没做过严格的对比评估。所以目前它在这块只能说占了一个理论上的生态位。
#
我理想中的 Agent Mesh 长什么样
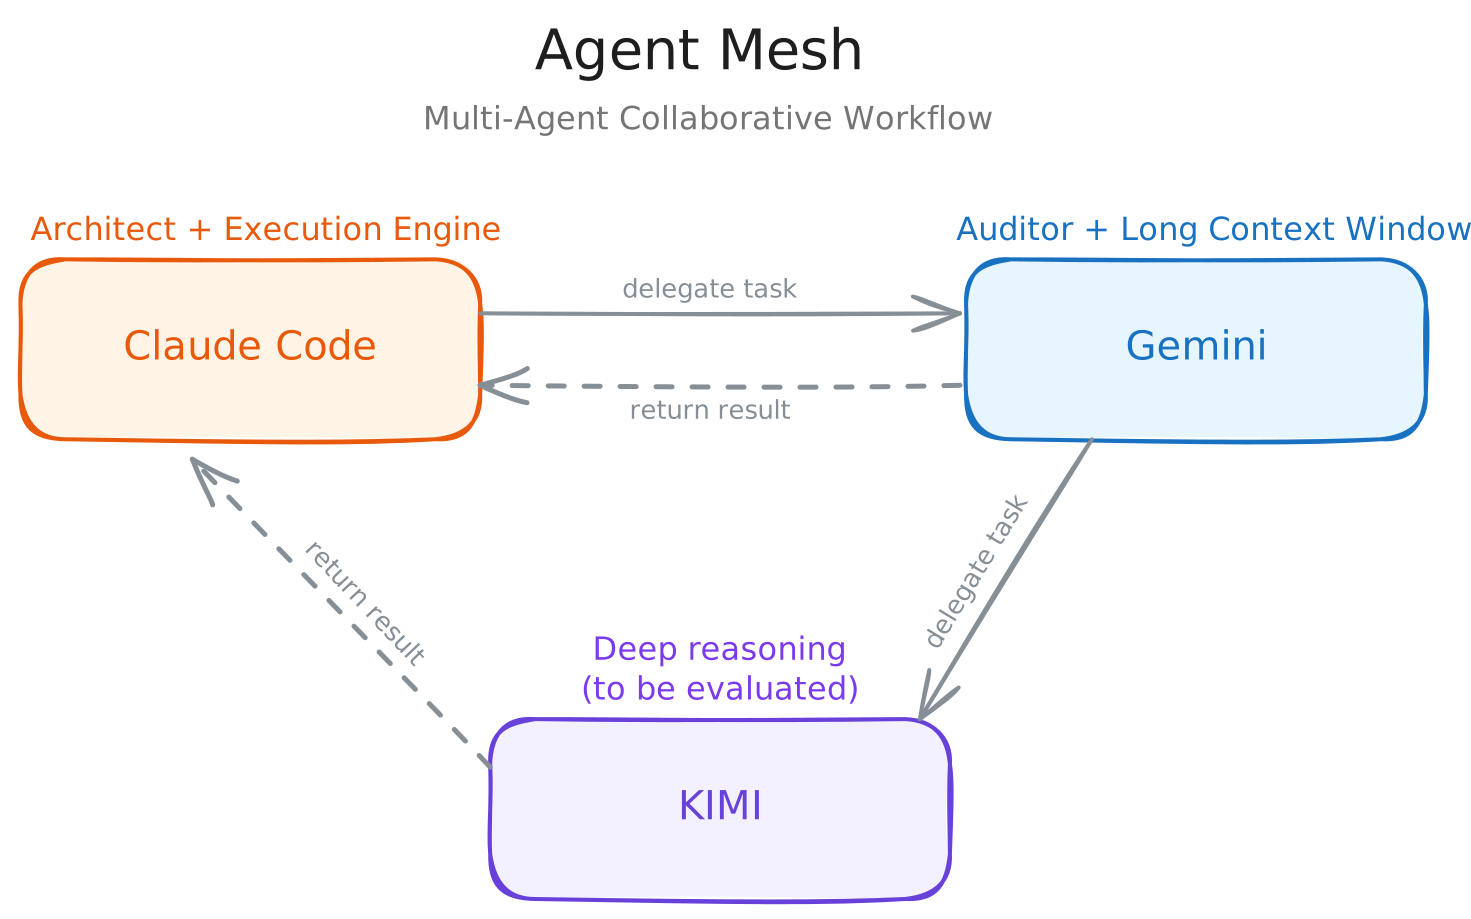
大部分时候 Claude Code 是干活的主力,代码基本都是它在写。但它遇到吃不下的大上下文时,比如我要重构一个模块但不知道会影响那 50 万行老代码的哪些地方,就丢给 Gemini,让它把整个仓库读一遍,告诉我影响范围。
反过来,Claude 执行完一份重构计划,我也会让 Gemini 拿着去跟实际项目文件交叉比对,看看有没有幻觉或坏掉的依赖。如果 Gemini 在审计过程中碰到特别硬的算法问题,还可以转手给 Kimi Code 去长考。
Kimi 想完之后也不直接改文件,而是把结论交回给 Claude Code,让 Claude 去落地执行。整个流程就是这样一个环:各自干各自最擅长的,结果互相流转。
#
隐形因素:Agent 架构 vs 基座模型
组合这些 Agent 时,我会同时看基座模型和工具的执行流程。
例如,Anthropic 的 Claude 3.5 Sonnet 可以在多个环境中使用:
- 作为 VS Code 里的标准聊天助手。
- 作为 Cursor IDE 内部的驱动引擎。
- 通过 OpenHands / Open Code 这样的开源 Agent 框架。
- 原生通过 Claude Code CLI 使用。
在我用过的工程工作流里,即使使用相同模型,不同工具的执行体验也有差别。Claude Code 的文件操作、命令执行和错误恢复配合起来更顺手。
#
社区里的类似探索
写完这篇之后,我发现社区里已经有人在做类似的事情。Humanize 是一个 Claude Code 插件,它实现了一个叫 RLCR 的工作流,全称 Ralph-Loop with Codex Review:Claude 负责写代码,Codex 独立审查,发现问题就打回去重做,循环往复直到通过为止。核心思路和 Agent Mesh 一样,让架构上不同的 AI 各司其职,通过 work-feedback loop 不断迭代,而不是指望一个模型一次搞定所有事。
#
写在最后
除了给同一个模型分配不同角色,我也会考虑模型本身和 Agent 工作方式的差异。LLM-DNA 是一个分析语言模型之间进化关系和功能差异的研究框架,已在 ICLR'26 以 Oral 形式发表,可以用来观察模型之间的差异。
在我的项目里,Claude Code 和 Gemini CLI 配合起来最顺手:Claude 负责写代码和执行,Gemini 负责结合整个仓库检查改动。